Funciona sin conexión
Con los motores locales, el audio y el texto se quedan en tu equipo: sin nube, sin cuenta.
Sin configuración de Python
Un solo instalador, con whisper.cpp incluido: elige un modelo y listo.
Funciona sin GPU
Solo CPU funciona de inmediato; la GPU (Vulkan/Metal) lo hace más rápido.
Cómo usar Whisper como herramienta de escritorio con WhisPaste
Un atajo, tu voz, texto en el cursor: sin cambiar de app por el medio.
Instala WhisPaste y elige un modelo Whisper
Descarga WhisPaste desde Microsoft Store, Mac App Store o GitHub. En el primer arranque, el asistente de configuración recomienda un motor y un nivel de calidad según tu idioma y tu memoria gráfica (en Apple Silicon: memoria unificada). Puedes cambiarlo en cualquier momento.
Deja que el modelo se descargue una vez
WhisPaste descarga en segundo plano el archivo de modelo de whisper.cpp elegido y lo verifica. La descarga se reanuda tras conexiones interrumpidas, así que una red inestable no te obliga a empezar de nuevo. Después, la transcripción funciona totalmente sin conexión.
Pulsa tu atajo y habla
Coloca el cursor donde quieras el texto, mantén pulsado tu atajo configurado y habla. whisper.cpp transcribe el audio en tu equipo y la transcripción aparece en el cursor: sin subida, sin pestaña del navegador, sin paso de copiar y pegar.
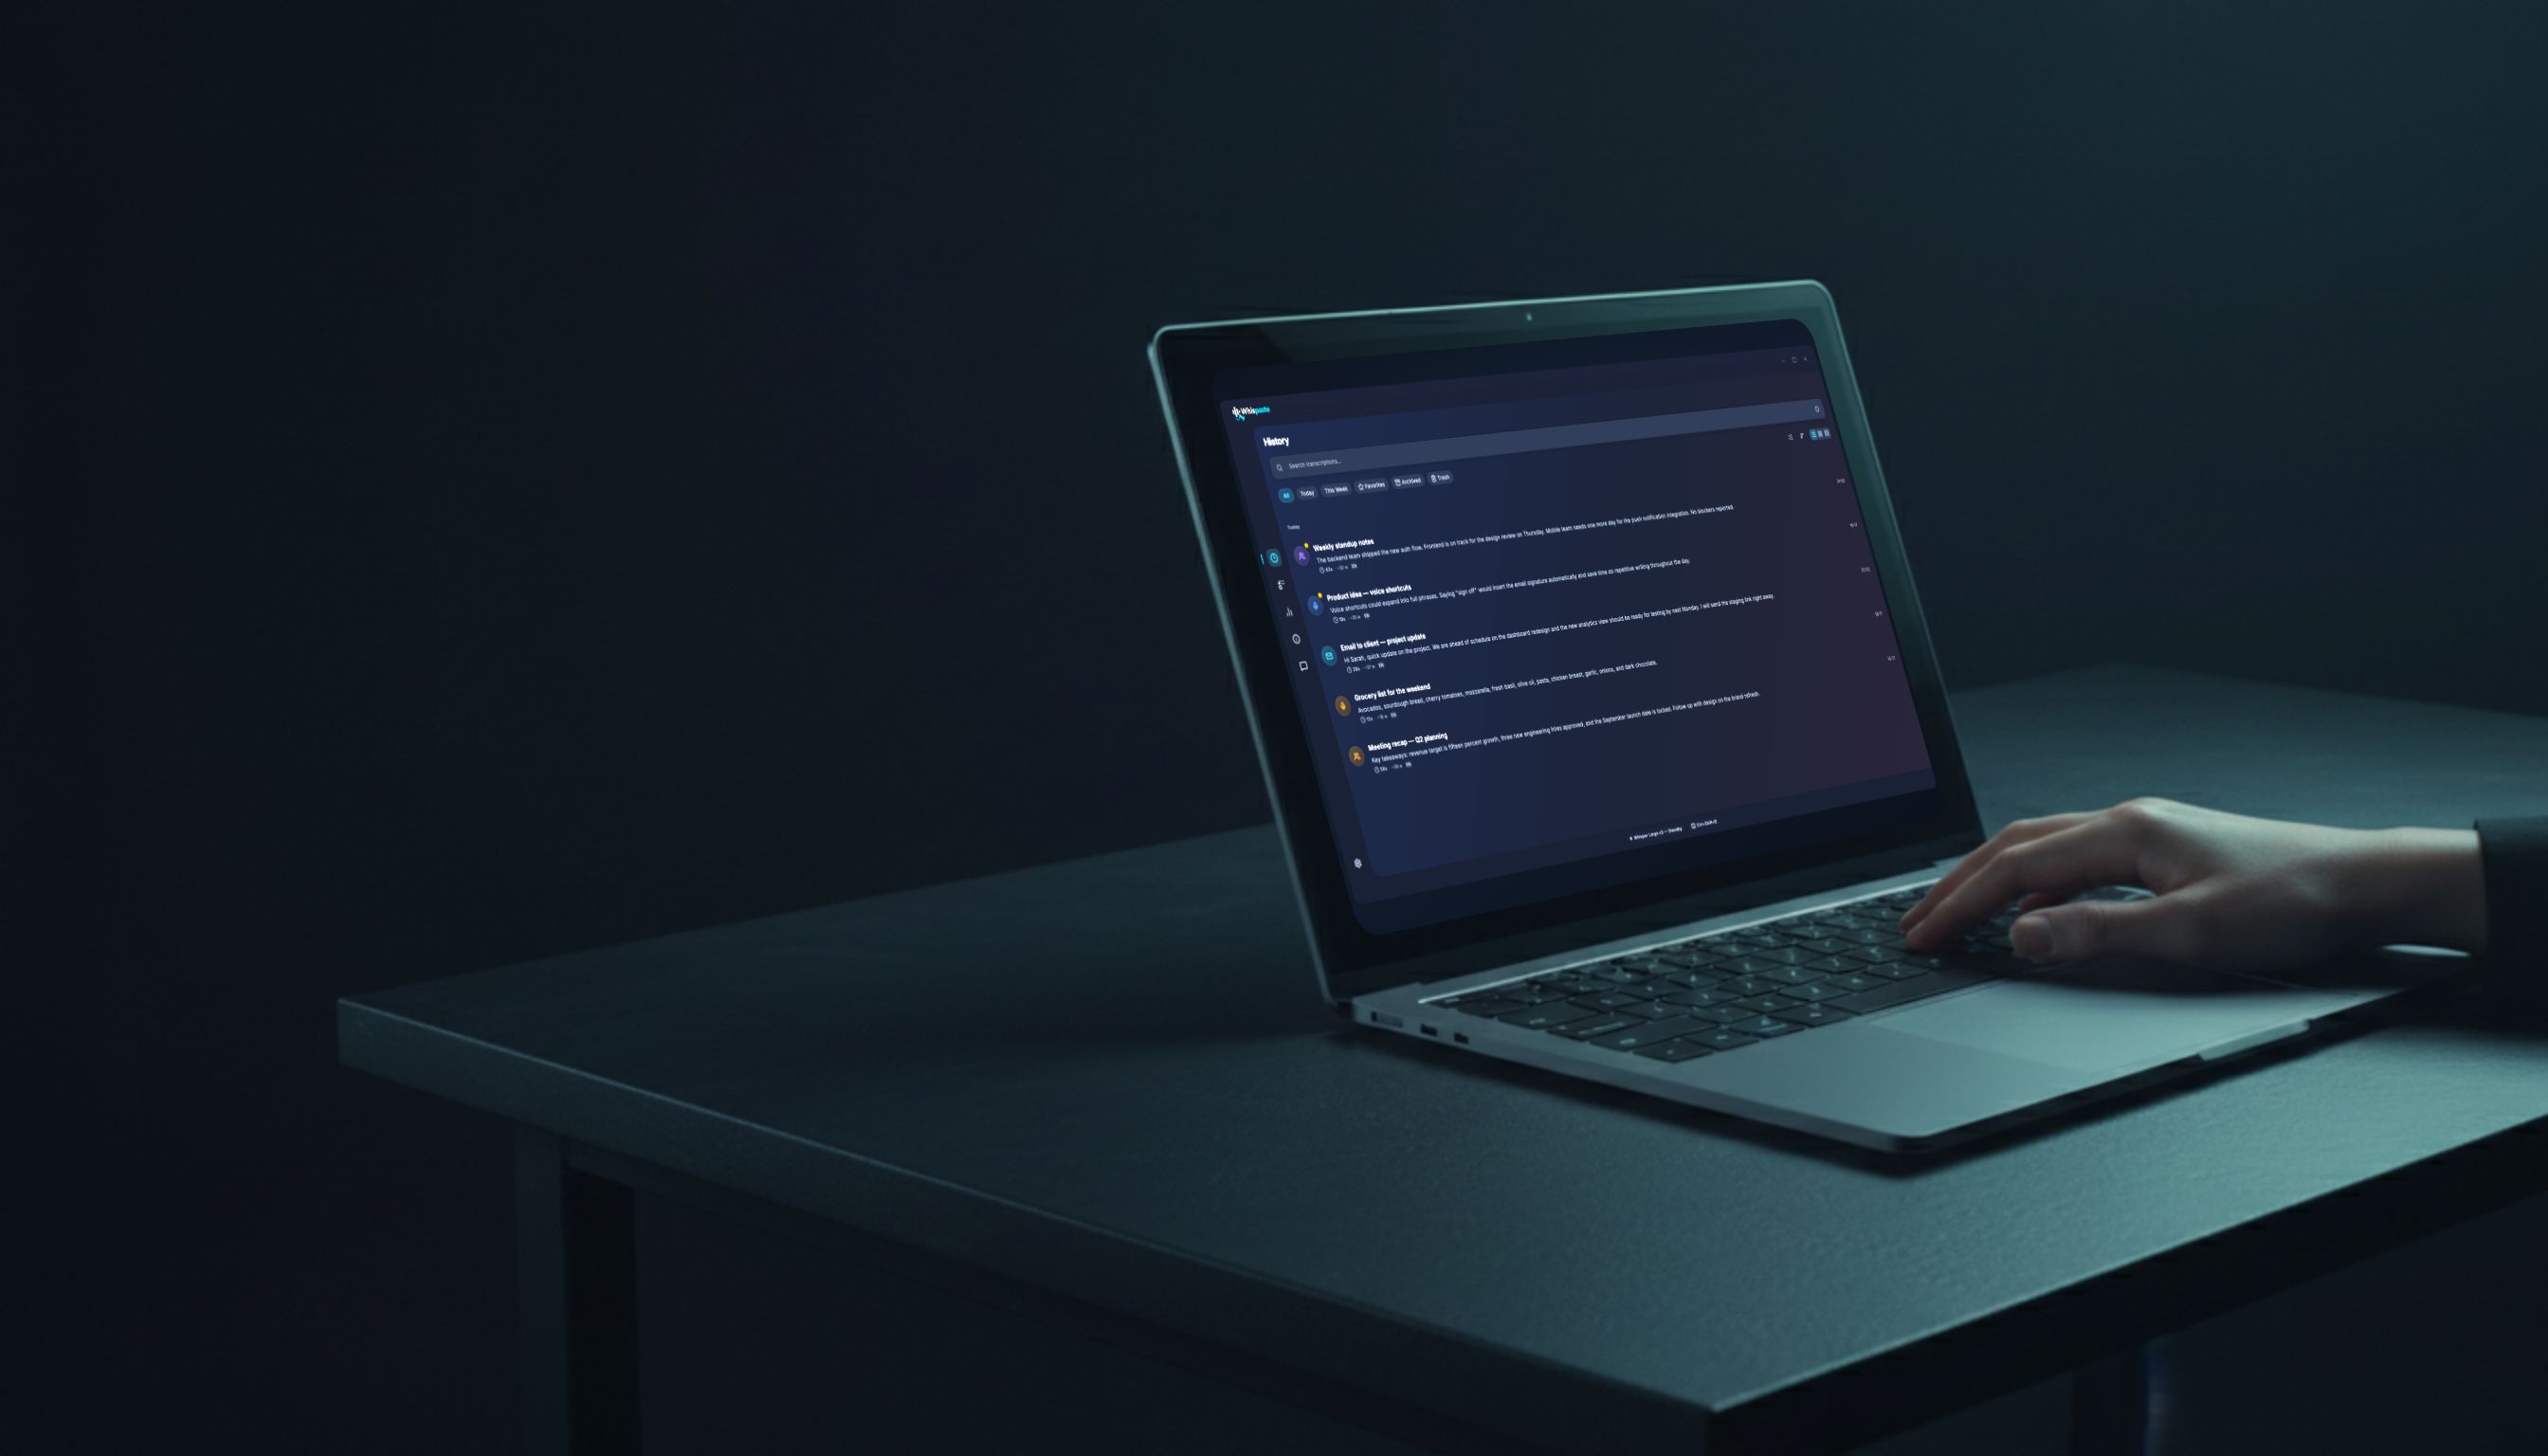
WhisPaste en el uso diario: las notas habladas se convierten en texto al instante, directamente en tu propio dispositivo.
Detalles técnicos
Instalación: un instalador, sin entorno de Python
WhisPaste integra whisper.cpp (el port en C++ de OpenAI Whisper) como biblioteca incluida en la descarga. Tras la instalación eliges un nivel de calidad entre las opciones (Quick & Compact, Balanced, Best Quality), la app lo descarga una vez y, a partir de ahí, la transcripción funciona totalmente sin conexión en tu equipo. Sin virtualenv, sin pip, sin toolkit de CUDA: la aceleración por GPU viene incluida en la descarga (Vulkan en Windows y Linux, Metal en Apple Silicon). Las tarjetas gráficas NVIDIA recientes pueden añadir un paquete CUDA opcional desde los ajustes.
Rendimiento: la CPU basta, una GPU lo hace más rápido
whisper.cpp funciona con la CPU normal en todos los equipos compatibles (Windows 10+, macOS 12 Monterey+ en Apple Silicon, Linux), así que un portátil de 8 GB sin GPU dedicada basta para el modelo compacto. Con aceleración por GPU (Vulkan en Windows y Linux, Metal en Apple Silicon) la misma transcripción llega notablemente más rápido: en nuestro benchmark en Apple Silicon con el modelo compacto, Metal fue unas 2,6 veces más rápido que solo la CPU. Apple Silicon comparte memoria entre CPU y GPU, así que 8 GB ya bastan para el modelo equilibrado. ¿Ninguna GPU utilizable? El segundo motor en el dispositivo de WhisPaste, Parakeet, usa una GPU cuando hay una disponible y fue varias veces más rápido que el modelo Whisper compacto en el mismo procesador (nuestro benchmark), a cambio de menos idiomas (unos 25 en lugar de 99).
Modelo compacto, mismo audio, medido con whisper.cpp en Apple Silicon (M5). Detalles en la página del benchmark.
Local frente a nube: el mismo Whisper, distintos compromisos
Whisper en local mantiene el audio en tu equipo, no cuesta nada por minuto y funciona sin internet, a cambio de una descarga única del modelo y algo más de RAM. Proveedores en la nube como OpenAI o Deepgram cambian esos recursos por velocidad bruta y los modelos más grandes. WhisPaste te deja elegir el proveedor en los ajustes: local por defecto, y cambiar a un proveedor en la nube cuando necesites la máxima velocidad en una grabación larga.
FAQ