Funciona offline
Com os motores locais, áudio e texto ficam na sua máquina — sem nuvem, sem conta.
Sem configuração de Python
Um instalador, com o whisper.cpp incluído — escolha um modelo e pronto.
Roda sem GPU
Só com CPU já funciona de imediato; a GPU (Vulkan/Metal) deixa mais rápido.
Como usar o Whisper como ferramenta de desktop com o WhisPaste
Um atalho, sua voz, texto no cursor — sem trocar de app no meio.
Instale o WhisPaste e escolha um modelo Whisper
Baixe o WhisPaste na Microsoft Store, na Mac App Store ou no GitHub. No primeiro uso, o assistente de configuração recomenda um motor e um nível de qualidade com base no seu idioma e na memória gráfica (em Apple Silicon: memória unificada). Você pode mudar isso a qualquer momento.
Deixe o modelo ser baixado uma vez
O WhisPaste busca o arquivo do modelo whisper.cpp escolhido em segundo plano e o verifica. O download retoma após conexões interrompidas, então uma rede instável não obriga você a começar de novo. Depois disso, a transcrição roda totalmente offline.
Pressione o atalho e fale
Posicione o cursor onde quer o texto, segure o atalho configurado e fale. O whisper.cpp transcreve o áudio na sua máquina e a transcrição aparece no cursor: sem envio, sem aba do navegador, sem etapa de copiar e colar.
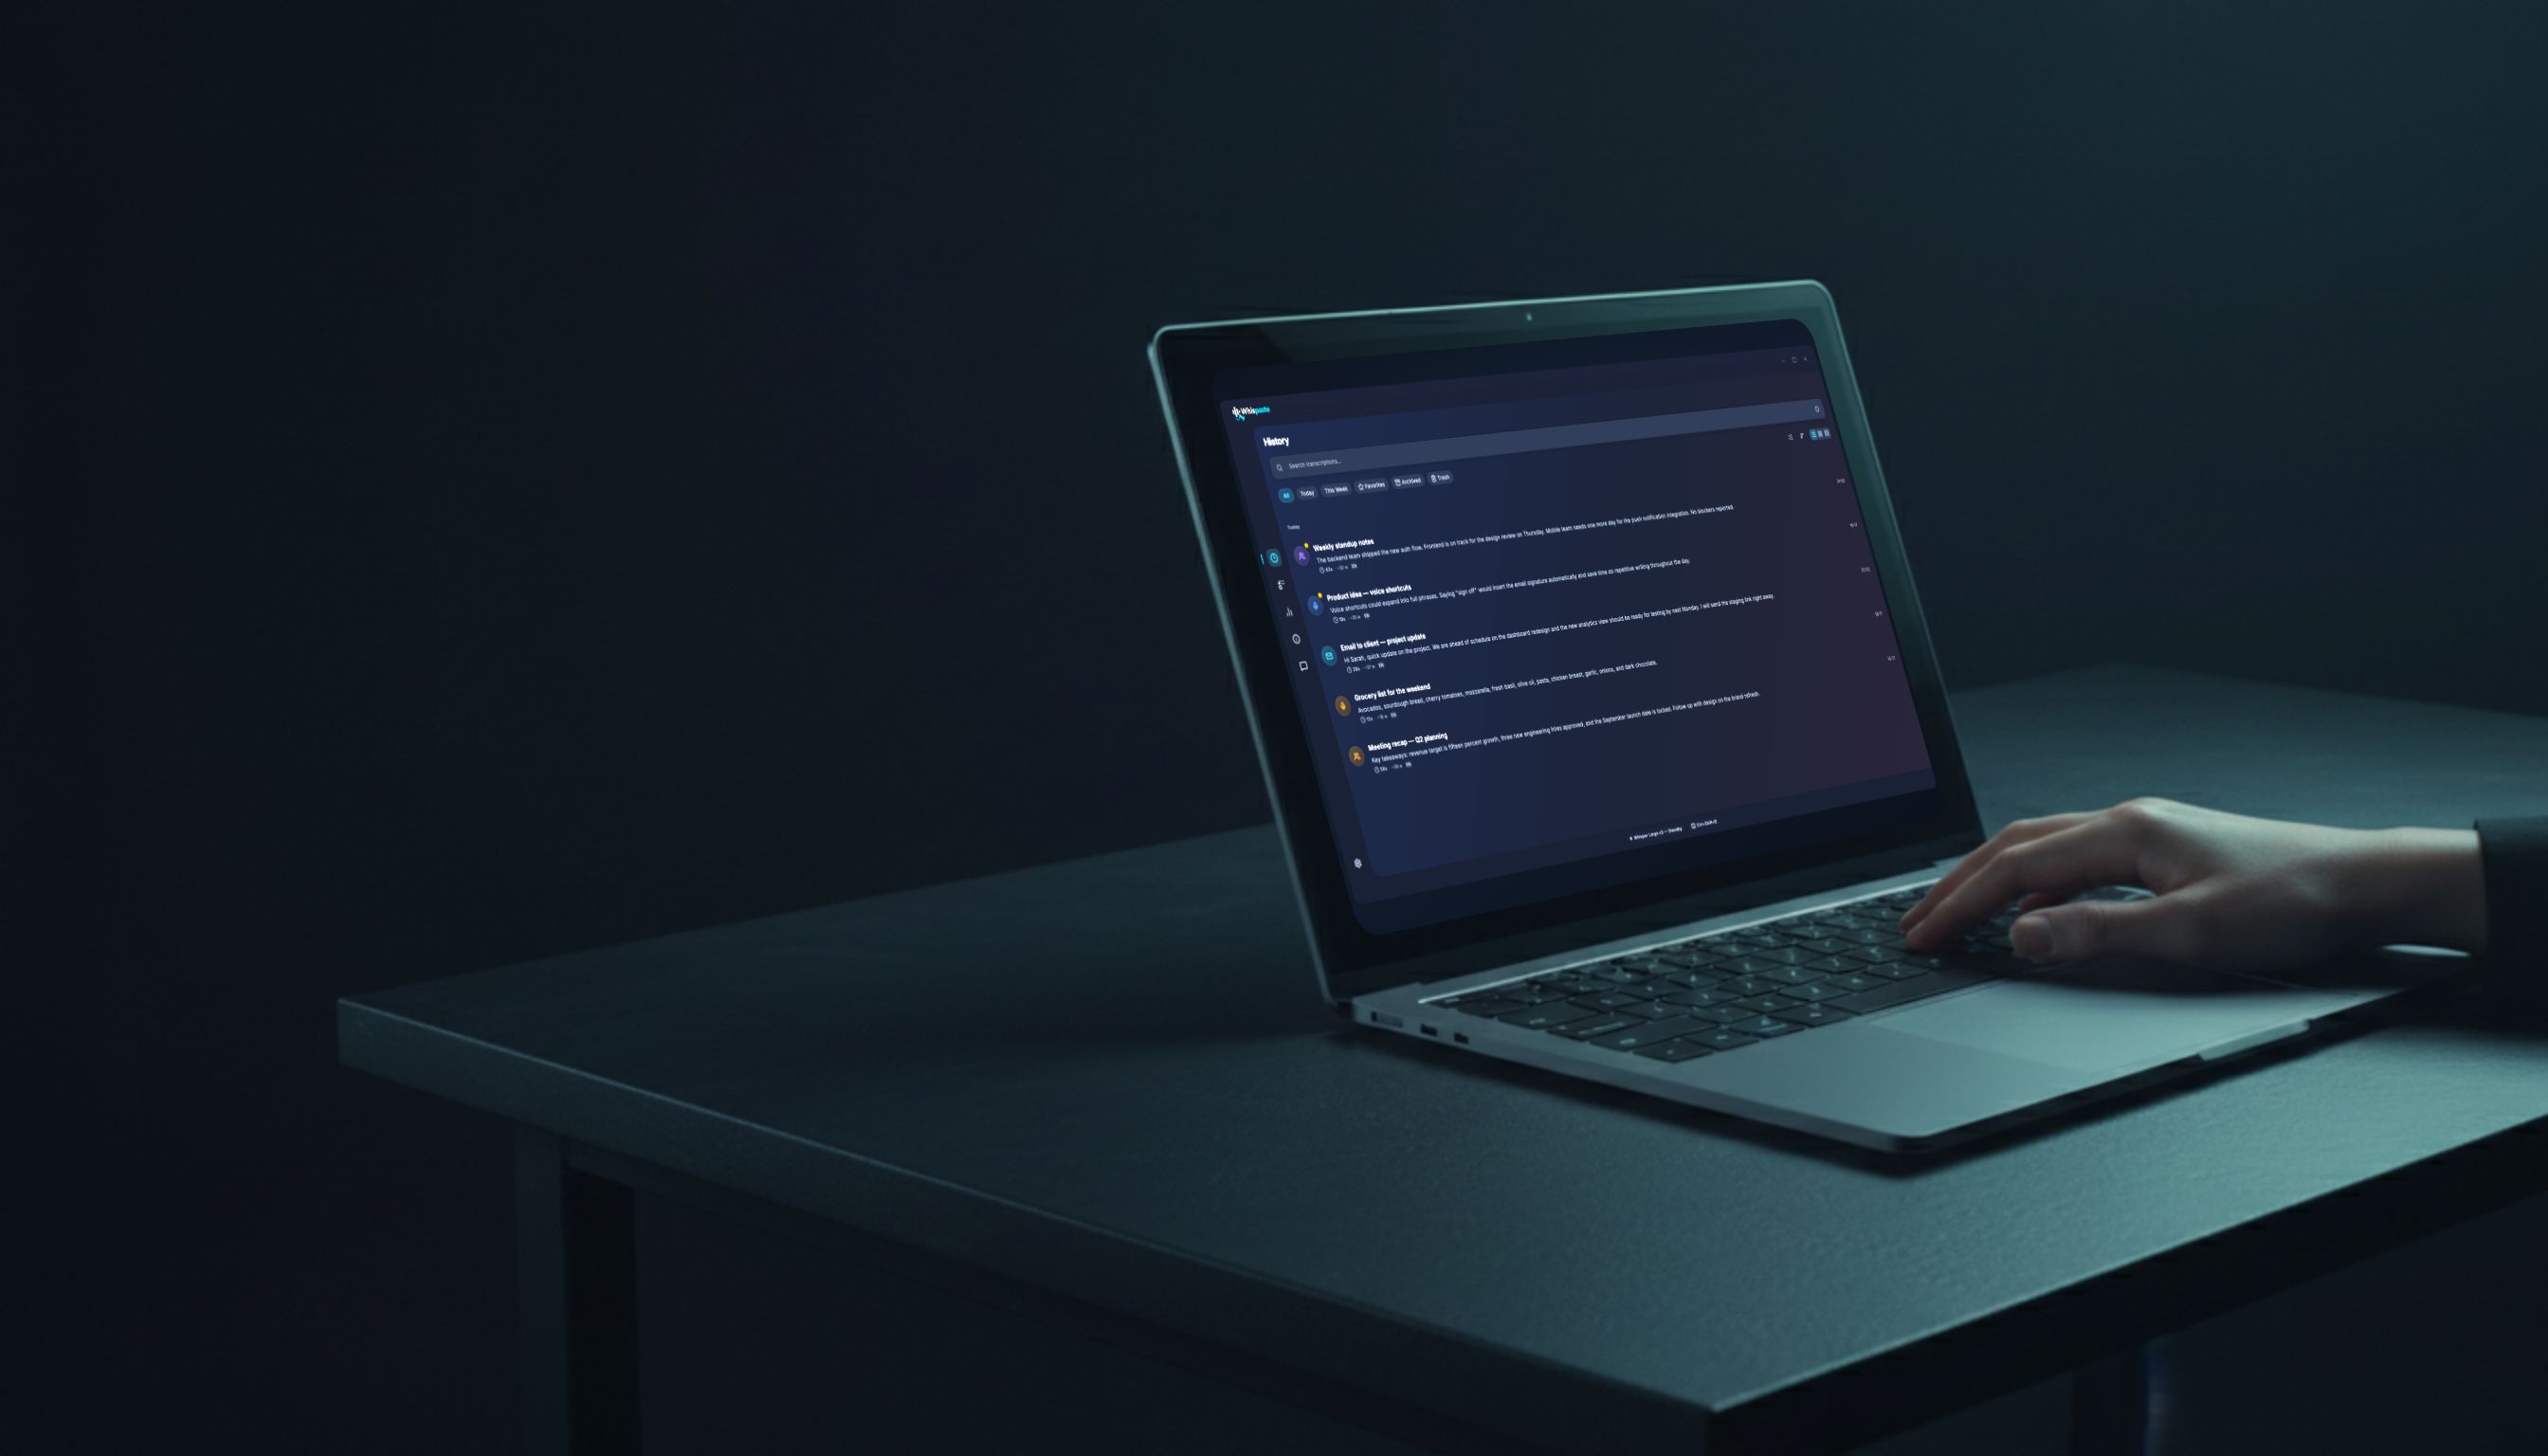
WhisPaste no uso do dia a dia: anotações faladas viram texto na hora, direto no seu próprio dispositivo.
Detalhes técnicos
Configuração: um instalador, sem ambiente Python
O WhisPaste incorpora o whisper.cpp (o port em C++ do OpenAI Whisper) como uma biblioteca incluída no download. Depois da instalação, você escolhe um nível de qualidade nos cartões (Compacto, Equilibrado, Melhor qualidade); o app baixa o modelo uma única vez e, a partir daí, a transcrição roda totalmente offline na sua máquina. Sem virtualenv, sem pip, sem toolkit CUDA: a aceleração por GPU já vem no download (Vulkan no Windows e no Linux, Metal em Apple Silicon). Placas NVIDIA recentes podem adicionar opcionalmente o pacote CUDA nas configurações.
Desempenho: a CPU basta, uma GPU deixa mais rápido
O whisper.cpp roda na CPU comum em todas as máquinas suportadas (Windows 10+, macOS 12 Monterey+ em Apple Silicon, Linux), então um notebook de 8 GB sem GPU dedicada basta para o modelo compacto. Com aceleração por GPU (Vulkan no Windows e no Linux, Metal em Apple Silicon), a mesma transcrição volta perceptivelmente mais rápido: no nosso benchmark em Apple Silicon com o modelo compacto, o Metal foi cerca de 2,6 vezes mais rápido que só a CPU. O Apple Silicon compartilha memória entre CPU e GPU, então 8 GB já cobrem o modelo equilibrado. Sem nenhuma GPU utilizável? O segundo motor no dispositivo do WhisPaste, o Parakeet, usa a GPU quando disponível e foi várias vezes mais rápido que o modelo compacto do Whisper no mesmo processador (nosso benchmark), ao custo de menos idiomas (cerca de 25 em vez de 99).
Modelo compacto, mesmo áudio, medido com whisper.cpp em Apple Silicon (M5). Detalhes na página de benchmark.
Local ou nuvem: o mesmo Whisper, compensações diferentes
O Whisper local mantém o áudio na sua máquina, não custa nada por minuto e funciona sem internet, ao preço de um download único do modelo e de um pouco mais de RAM. Provedores em nuvem como OpenAI ou Deepgram trocam esses recursos por velocidade bruta e pelos maiores modelos. O WhisPaste deixa você escolher o provedor nas configurações: fique local por padrão e mude para um provedor em nuvem quando precisar da máxima velocidade numa gravação longa.
FAQ