可离线使用
使用本地引擎时,音频和文本都留在你的电脑上——无需云端,无需账户。
无需 Python 设置
一个安装程序,内置 whisper.cpp——选个模型,就完成了。
无需 GPU 也能运行
仅 CPU 开箱即用;GPU(Vulkan/Metal)让它更快。
如何借助 WhisPaste 把 Whisper 用作桌面工具
一个快捷键,你的声音,光标处的文字——中间无需切换应用。
安装 WhisPaste 并选择 Whisper 模型
从 Microsoft Store、Mac App Store 或 GitHub 下载 WhisPaste。首次启动时,设置助手会根据你的语言和显存(Apple Silicon 上为统一内存)推荐一个引擎和质量档位。你随时可以更改。
让模型下载一次
WhisPaste 会在后台获取所选的 whisper.cpp 模型文件并进行校验。网络连接中断后下载会断点续传,因此不稳定的网络不会迫使你从头开始。之后,转写便完全离线运行。
按下快捷键并说话
把光标放在你希望文字出现的位置,按住你设置的快捷键并开口说话。whisper.cpp 在你的电脑上转写音频,转写文本出现在光标处:无需上传,无需浏览器标签页,也无需复制粘贴。
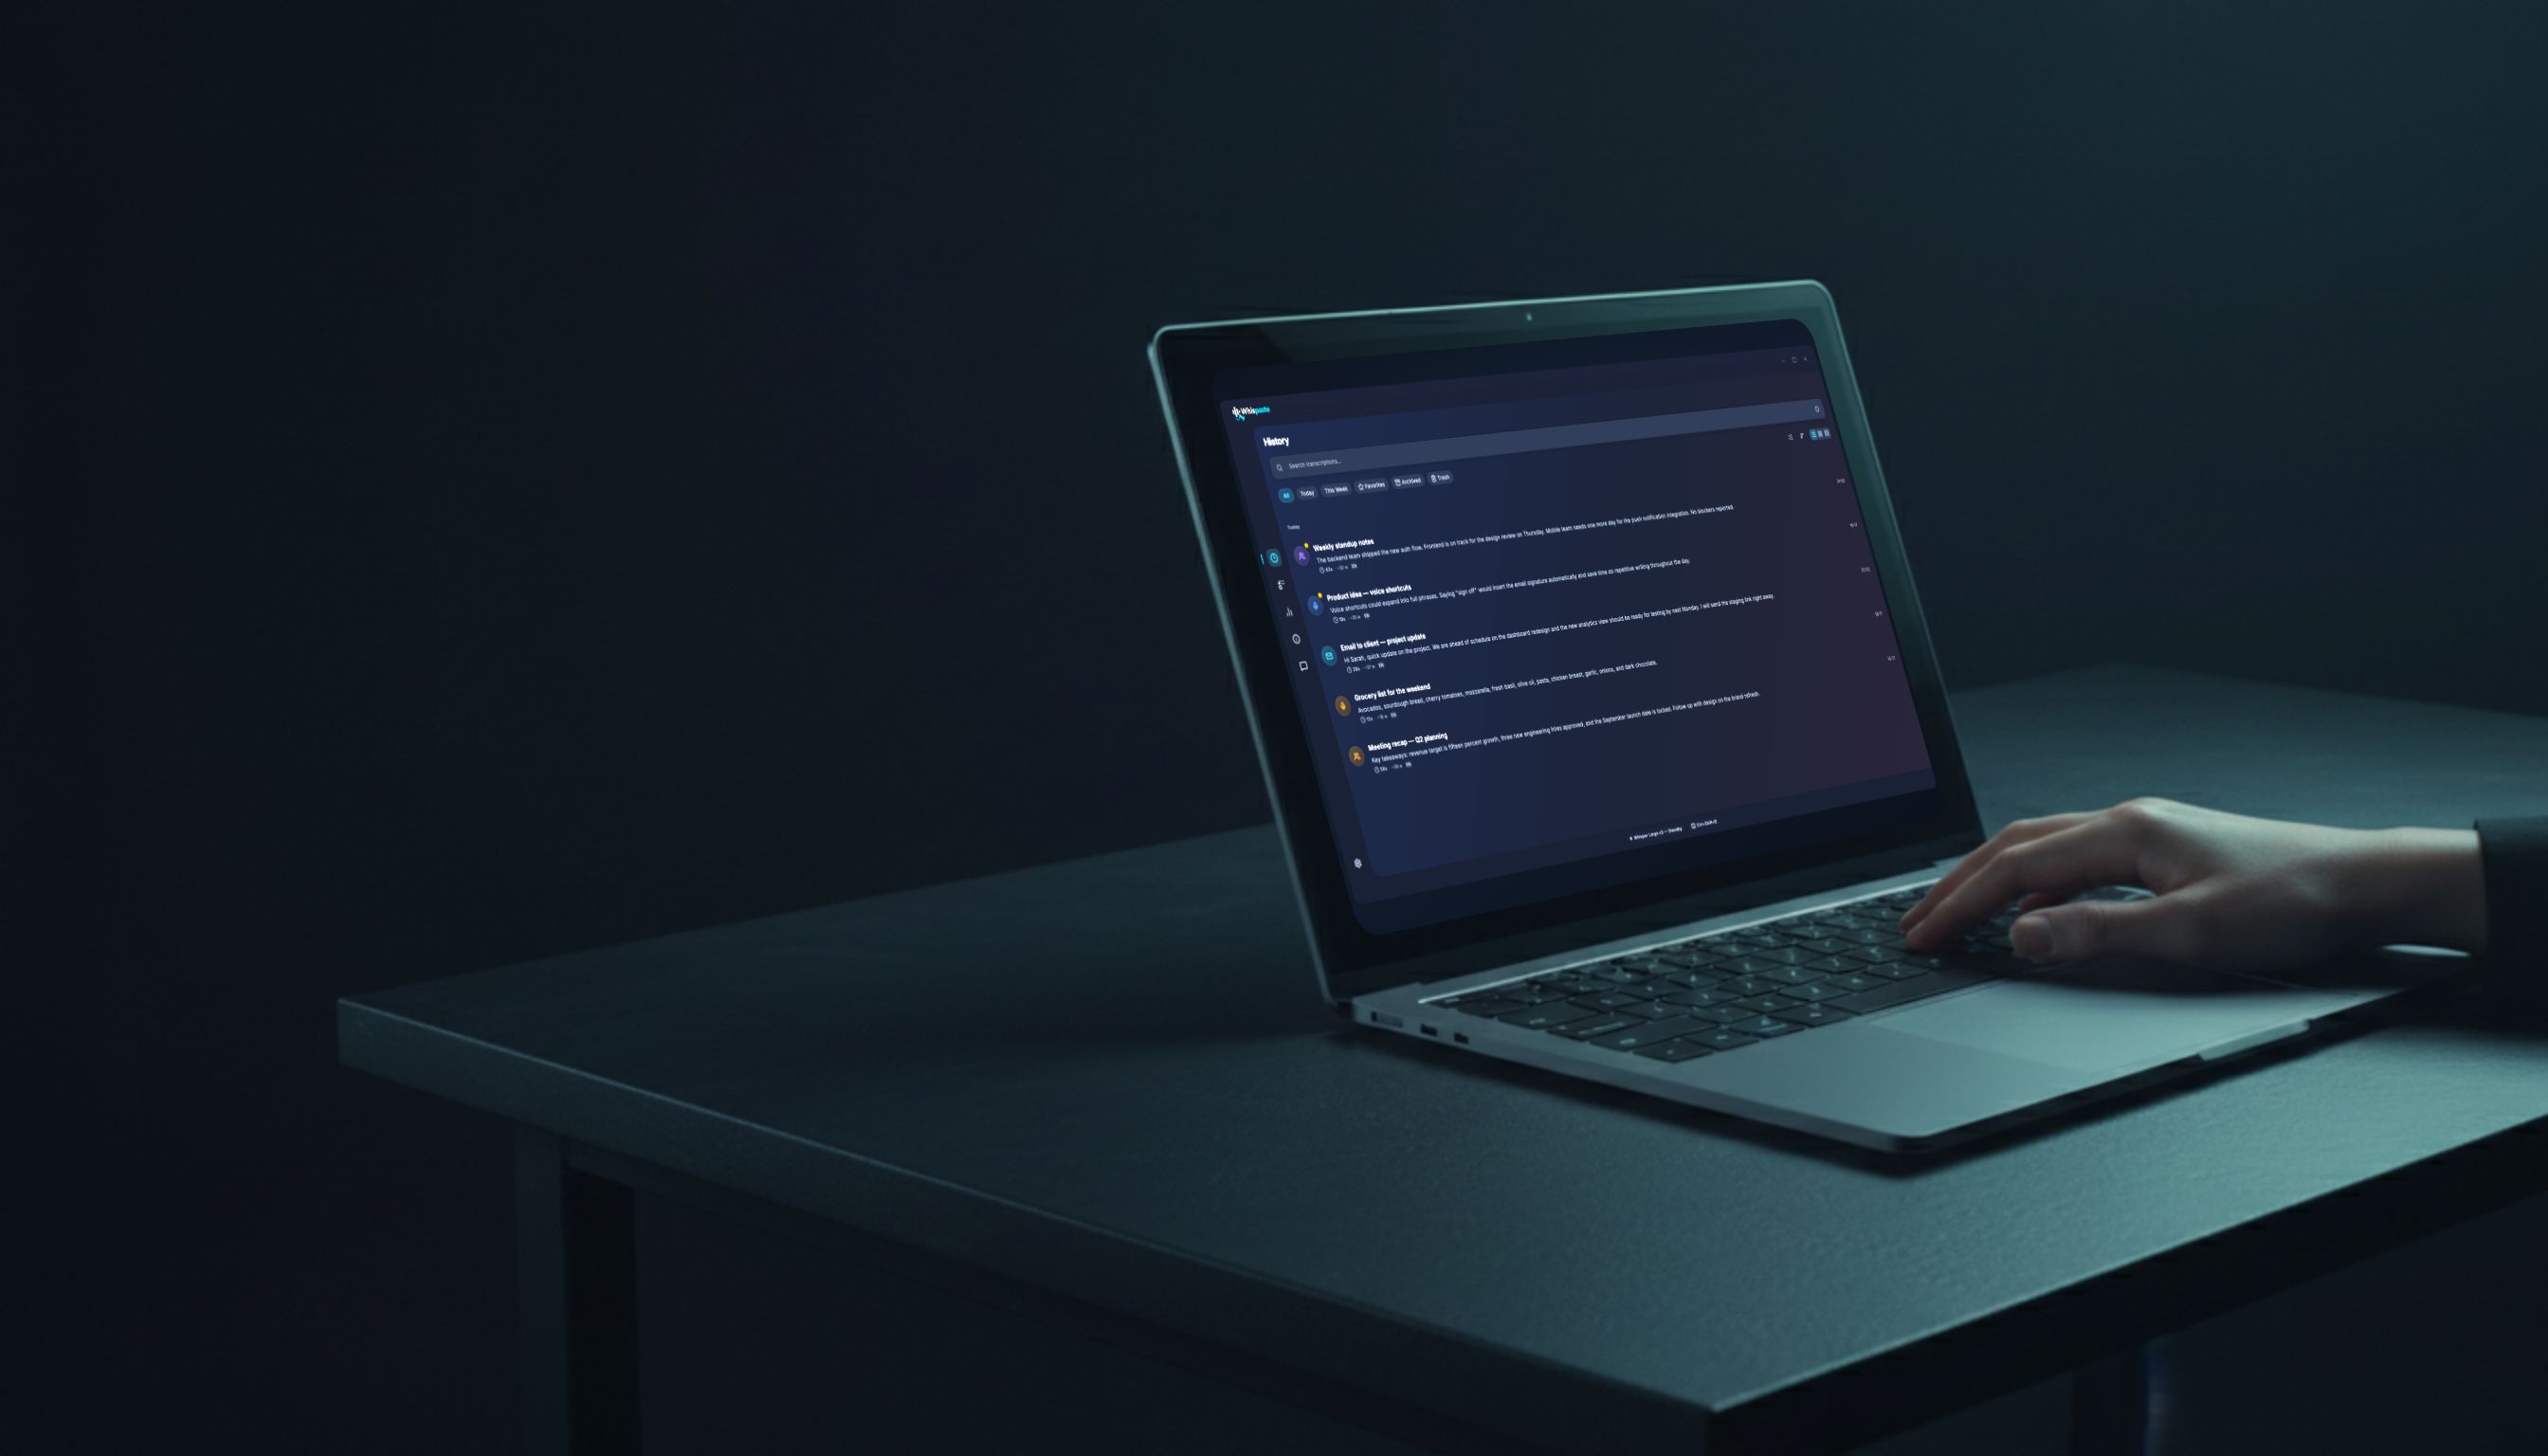
日常使用中的 WhisPaste:你说出的笔记即刻变成文字,就在你自己的设备上完成。
技术细节
设置:一个安装程序,无需 Python 环境
WhisPaste 将 whisper.cpp(OpenAI Whisper 的 C++ 移植版)直接嵌入桌面程序。安装后,你从卡片中选择一个质量档位(紧凑型、均衡型、高级型),应用下载一次该模型,此后转写便完全在你的电脑上离线运行。无需 virtualenv,无需 pip,无需 CUDA 工具包——GPU 加速已包含在下载内容中(Windows 和 Linux 使用 Vulkan,Apple Silicon 使用 Metal)。较新的 NVIDIA 显卡可以在设置中额外添加可选的 CUDA 扩展包。
性能:CPU 已足够,GPU 让它更快
whisper.cpp 在每台受支持的机器上都能在普通 CPU 上运行(Windows 10+、Apple Silicon 上的 macOS 12 Monterey+、Linux),因此没有独立 GPU 的 8 GB 笔记本电脑就足以运行紧凑型模型。启用 GPU 加速(Windows 和 Linux 使用 Vulkan,Apple Silicon 使用 Metal)后,同一段转写会明显更快地返回:在我们于 Apple Silicon 上使用紧凑型模型的基准测试中,Metal 约为仅用 CPU 时的 2.6 倍。Apple Silicon 在 CPU 与 GPU 之间共享内存,因此 8 GB 已足以运行均衡型模型。完全没有可用的 GPU?WhisPaste 的第二种设备端引擎 Parakeet 可用时使用 GPU,在同一处理器上比紧凑型 Whisper 模型快数倍(我们的基准测试),代价是语言范围较窄(约 25 种语言,而非 99 种)。
紧凑型模型,相同音频,在 Apple Silicon(M5)上使用 whisper.cpp 测得。基准测试页面提供详情。
本地与云端:同一个 Whisper,不同的取舍
本地 Whisper 把音频留在你的电脑上,每分钟无需付费,无需联网,代价是需要一次性下载模型并占用稍多的内存。OpenAI 或 Deepgram 等云端服务商则用这些资源换取原始速度和最大的模型。WhisPaste 允许你在设置中选择服务商:默认保持本地,在处理长录音、需要极致速度时再切换到云端服务商。
常见问题